KI-Chatbot testen: Wenn eine KI die andere bewertet
Von Waldemar Siebert · · 0 Kommentare
Klassische Testautomatisierung arbeitet häufig mit einem eindeutigen Testorakel. Für eine Eingabe ist ein erwartetes Ergebnis definiert, mit dem die tatsächliche Systemausgabe verglichen wird. Wer einen KI-Chatbot testen will, stößt mit diesem Prinzip an Grenzen, sobald die Antworten von generativer KI erzeugt werden.
In einem Kundenprojekt wird ein digitaler Serviceassistent auf Basis generativer KI entwickelt. Der Chatbot bearbeitet unterschiedliche Anliegen, darunter allgemeine Serviceanfragen, Beschwerden sowie die Meldung von Notfällen und Sicherheitsvorfällen. Vorgesehen ist die Einbindung sowohl in eine mobile Anwendung als auch in eine Website. Dort soll der Chatbot als zentrale Anlaufstelle für sämtliche Anliegen dienen.
Aus Sicht der Qualitätssicherung ergibt sich daraus eine grundlegende Herausforderung: Das System verhält sich nicht deterministisch. Identische Eingaben führen nicht zwangsläufig zu identischen Ausgaben. Dieses Verhalten muss bei der Teststrategie entsprechend berücksichtigt werden.
Warum klassische Testverfahren bei generativer KI an Grenzen stoßen
Klassische Softwaresysteme lassen sich häufig anhand eindeutig erwarteter Ergebnisse überprüfen. Bei generativen Sprachmodellen existiert dagegen nicht immer nur eine einzige korrekte Antwort. Eine einzelne Soll-Antwort würde die Bandbreite zulässiger Antworten daher nicht angemessen abbilden.
Traditionelle Testverfahren mit festen Soll-Ist-Vergleichen sind damit nur eingeschränkt einsetzbar. Der Prüfgegenstand verlagert sich von der Übereinstimmung mit einem konkreten erwarteten Ergebnis auf die Erfüllung definierter Qualitätskriterien.
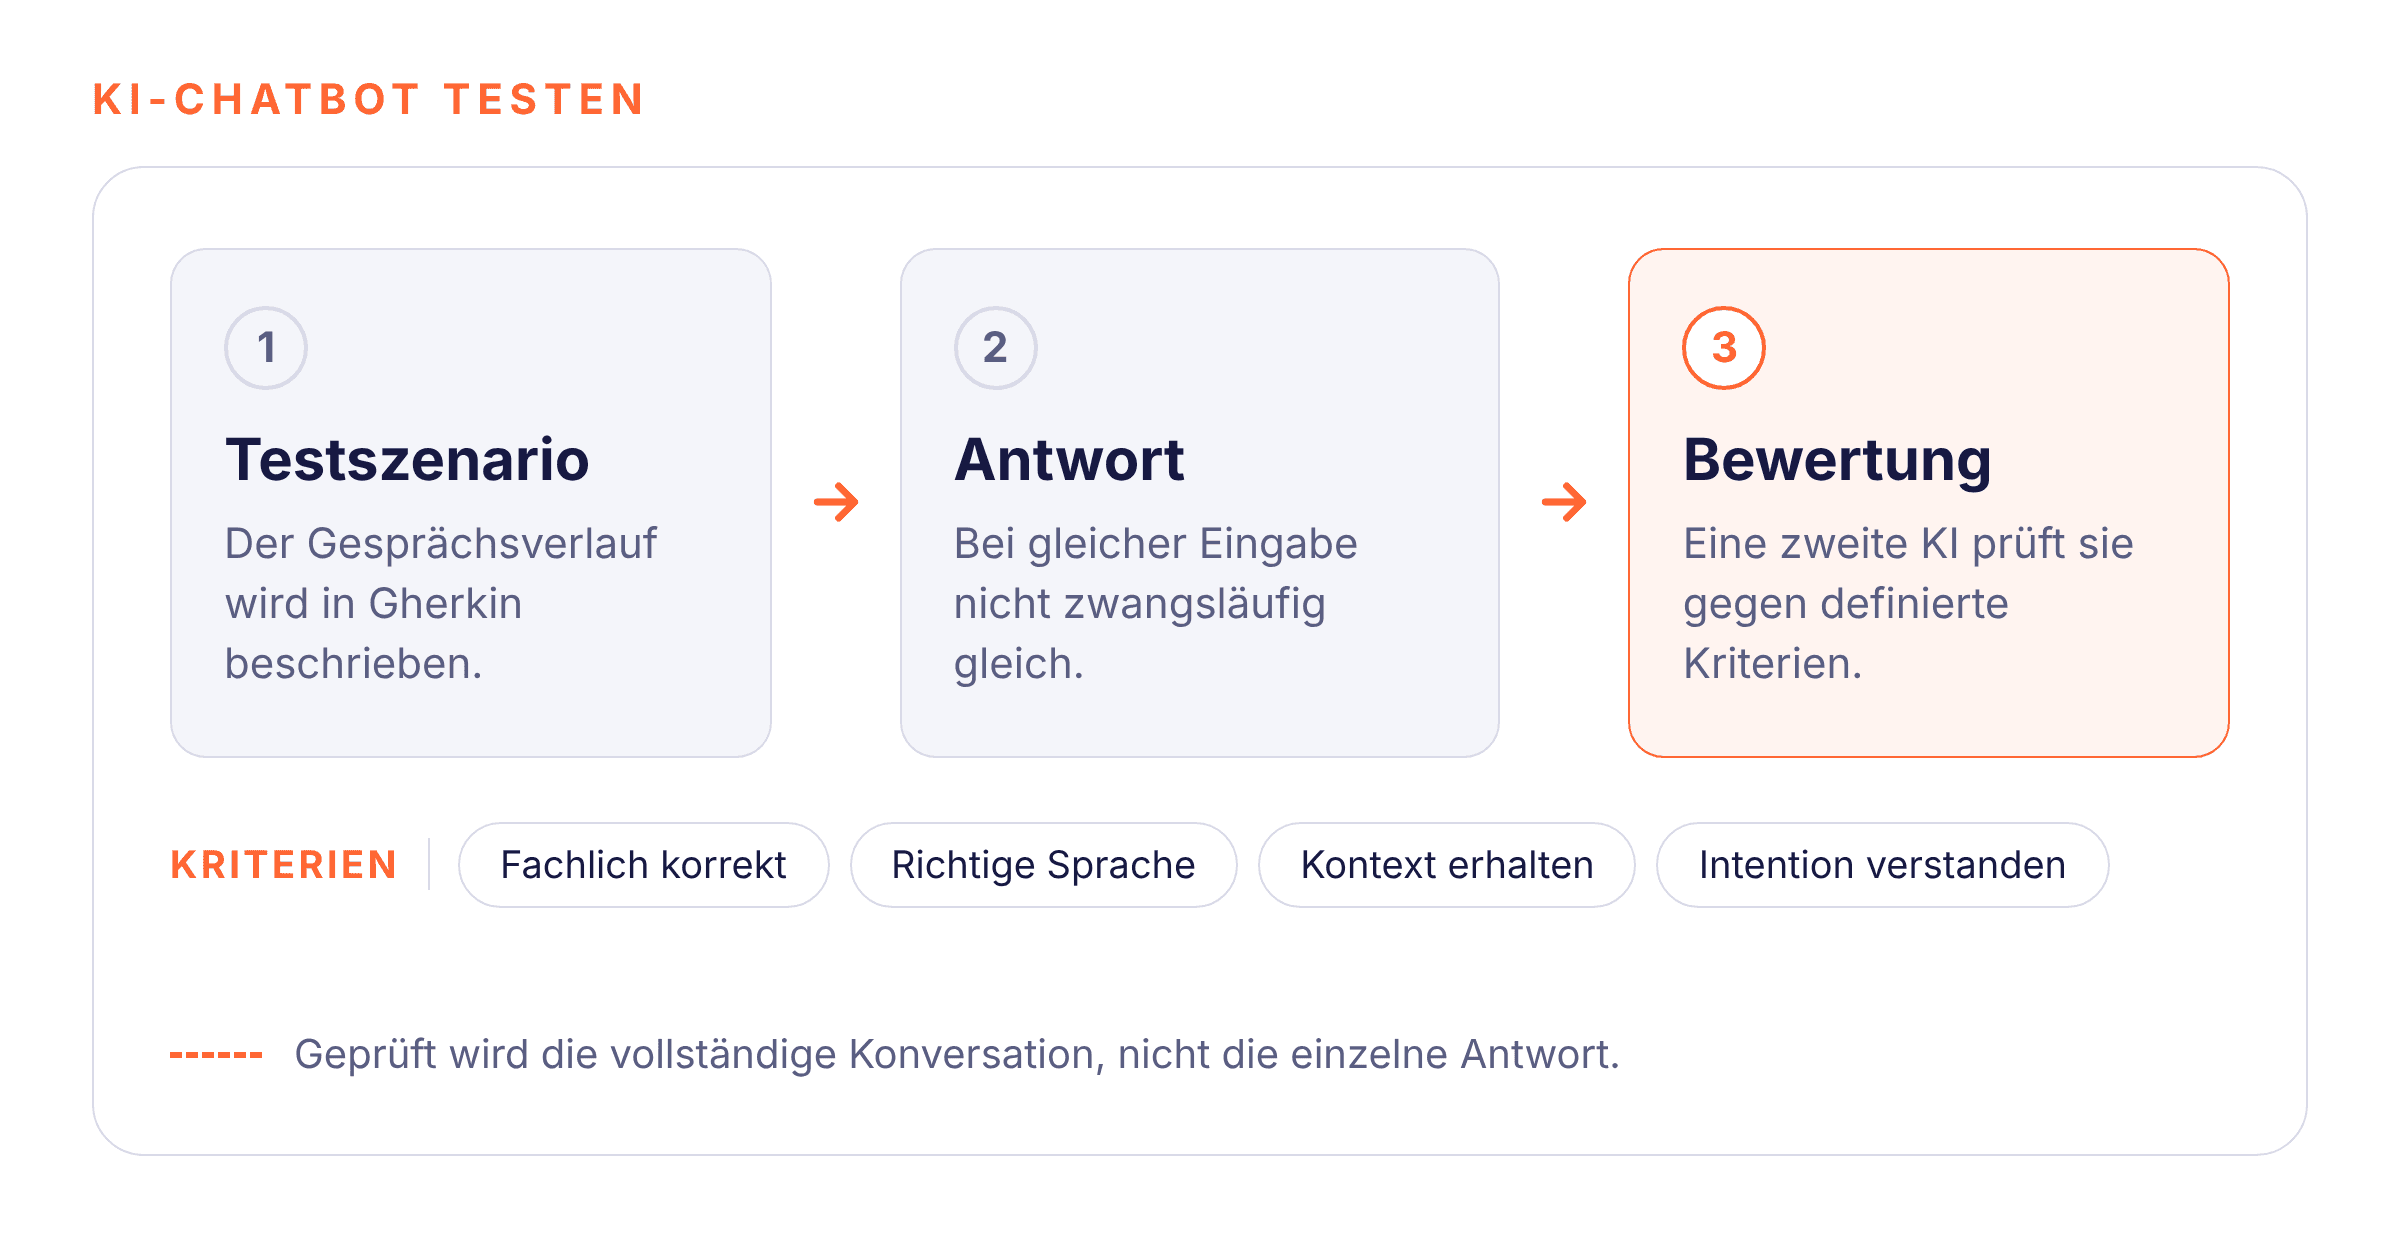
Im Projekt wurden dafür unter anderem folgende Prüffragen zugrunde gelegt:
- Wurde die Anfrage fachlich korrekt beantwortet?
- Ist die Antwort in der richtigen Sprache formuliert?
- Bleibt der Chatbot innerhalb des aktuellen Gesprächskontextes?
- Enthält die Antwort unangemessene oder beleidigende Inhalte?
- Wurde die Nutzerintention richtig verstanden?
Diese Kriterien spezifizieren keine konkrete Ausgabe, sondern beschreiben die Eigenschaften, die eine zulässige Ausgabe aufweisen muss. Sie bilden damit die Grundlage für eine Bewertung, die ohne eine starre Soll-Antwort auskommt.
Beobachtetes Systemverhalten im Testbetrieb
Zwei Effekte traten im Projektverlauf besonders deutlich hervor.
Der erste betrifft die Kontextstabilität über längere Konversationen. In einzelnen Fällen verliert das Sprachmodell den Gesprächskontext oder berücksichtigt vorherige Dialogschritte nicht mehr ausreichend. Derartige Kontextverluste können zu inkonsistenten Antworten führen und eine reproduzierbare Testdurchführung erschweren.
Der zweite Effekt betrifft die Stabilität der Testergebnisse. Vereinzelt treten flüchtige Testergebnisse auf, da identische Eingaben unterschiedliche Antworten erzeugen können. Flaky Testergebnisse können damit nicht nur durch die Testimplementierung entstehen. Auch das nicht-deterministische Verhalten des Testobjekts kann dazu beitragen und muss bei der Auswertung berücksichtigt werden.
Bewertung statt Vergleich: eine KI prüft die Ergebnisse der anderen KI
Auf Grundlage dieser Herausforderungen wurde eine KI-gestützte Teststrategie entwickelt. Anstelle eines Abgleichs mit festen Antworten werden die vom Chatbot erzeugten Ausgaben durch eine zweite KI bewertet. Daraus entsteht ein mehrstufiger Validierungsprozess, bei dem eine KI die Qualität der Ergebnisse einer anderen KI anhand definierter Kriterien überprüft.
Der Ablauf umfasst drei Stufen:
- Die Tests werden mit Gherkin und BDD spezifiziert. Die Szenarien definieren den Gesprächsverlauf sowie die fachlichen Anforderungen an den Chatbot.
- Nach der Ausführung analysiert das Framework DeepEval die generierten Antworten anhand zuvor definierter Qualitätskriterien.
- Merkmale wie Relevanz, Sprachqualität, Kontextbezug und Antwortverhalten werden automatisiert bewertet.
Der methodische Vorteil liegt in der Entkopplung der Prüfung vom konkreten Wortlaut. Die Validierung erfolgt ohne starre Soll-Antworten und kann dadurch auch dann angewendet werden, wenn das Modell dieselbe fachliche Aussage unterschiedlich formuliert.
Konversationen als Testgegenstand
Die Testfälle bilden vollständige Gesprächsverläufe ab. Der Schwerpunkt liegt auf dem Erhalt des Gesprächskontextes über mehrere Dialogschritte hinweg. Gegenstand der Validierung sind komplette Konversationen und nicht nur einzelne Antworten.
Damit lässt sich insbesondere prüfen, ob der Gesprächskontext auch über mehrere Dialogschritte hinweg erhalten bleibt und vorherige Informationen bei späteren Antworten weiterhin berücksichtigt werden.
Gherkin bietet für diese Abbildung eine geeignete Notation, da sich ein Dialog als nachvollziehbare Schrittfolge beschreiben lässt und die fachliche Anforderung dabei in lesbarer Form erhalten bleibt.
Ausführung, Pipeline und Auswertung
Für die Testausführung kommt das Python-Framework Behave zum Einsatz. Es ermöglicht die BDD-basierte Umsetzung und Ausführung der in Gherkin beschriebenen Szenarien.
Die automatisierten Tests werden über eine GitLab-CI/CD-Pipeline ausgeführt. Nach jedem Testlauf werden HTML-Reports erzeugt. Die Gliederung nach Features und Szenarien unterstützt eine schnelle Analyse der Testergebnisse und erleichtert die Zuordnung auffälliger Ergebnisse zu den jeweiligen Testszenarien.
KI in der Testfallerstellung
Künstliche Intelligenz wird im Projekt an einer zweiten Stelle des Testprozesses eingesetzt, nämlich bei der Erstellung der Testfälle.
Auf Basis der dokumentierten Anforderungen wurde ein GitHub-Copilot-Skill entwickelt, der Gherkin-Features und Testszenarien automatisch generiert. Die KI analysiert die fachlichen Anforderungen und leitet daraus strukturierte Testszenarien ab.
Ein wesentlicher Anteil der manuellen Erstellung von Feature-Dateien entfällt dadurch. Die Testautomatisierung wird somit bereits in der Spezifikationsphase unterstützt. Bei einer großen Anzahl an Anforderungen reduziert dieser Ansatz den manuellen Aufwand und sorgt gleichzeitig für eine konsistente Struktur der erstellten Testfälle.
Zentrale Erkenntnisse
- Bei generativer KI steht häufig keine einzelne erwartete Antwort als Testorakel zur Verfügung. Geprüft wird gegen Qualitätskriterien statt gegen eine starre Soll-Antwort.
- Testgegenstand ist die vollständige Konversation und nicht nur die einzelne Antwort.
- Kontextverlust über mehrere Dialogschritte trat im Projekt tatsächlich auf und erschwert die reproduzierbare Testdurchführung.
- Nicht-deterministisches Antwortverhalten kann zu Flakiness beitragen und muss bei der Teststrategie berücksichtigt werden.
- KI wird an zwei Stellen des Testprozesses eingesetzt: bei der Bewertung der Ergebnisse und bei der Erstellung der Testfälle.
Fazit
Klassische Testmethoden lassen sich nur eingeschränkt auf KI-basierte Anwendungen übertragen. Statt ausschließlich deterministische Ergebnisse zu erwarten, muss die Qualität generierter Antworten anhand definierter Bewertungskriterien überprüft werden.
Der beschriebene Ansatz verbindet dazu die Bewertung einer KI durch eine zweite KI, DeepEval als Bewertungsframework und eine BDD-basierte Testarchitektur, die vollständige Gesprächsverläufe abbildet. Ergänzend unterstützt KI bereits die Erstellung der Testfälle und reduziert dadurch den manuellen Aufwand innerhalb des Testautomatisierungsprozesses.
Begeisterter Entwickler, Trainer und Berater zu allem Themen rund um agile Softwareentwicklung, Softwarequalität und Testautomatisierung.
Gründer und Geschäftsführer der Firma SimplyTest GmbH
Das könnte Dich auch interessieren
 Barrierefreiheit im Softwaretest: Was das BFSG für Testteams bedeutet
 Ein QA-Workflow mit MCP Playwright Server und Visual Studio Code
 Desktop Testautomatisierungs-Frameworks
 Testautomatisierung mit Playwright, Gherkin und Cucumber unter Zuhilfenahme der Page-Object Model Methode
 Java-Projekt mit Playwright, TestNG und Allure (mithilfe des Page Object Model)
 Java Projekt mit JUnit5, Cucumber7 und Allure
Kommentare
Hinterlasse einen Kommentar
An der Diskussion beteiligen?
Hinterlasse uns deinen Kommentar!
Dein Kommentar geht per E-Mail an die Redaktion – er erscheint nicht sofort auf der Seite. Deine E-Mail-Adresse wird nicht veröffentlicht. Erforderliche Felder sind mit Stern markiert.